发现 / 落地案例 / Inner Monologue:反馈驱动的机器人重规划
Inner Monologue:反馈驱动的机器人重规划
仅演示把动作成败、场景变化和人类反馈交回规划模型,让机器人失败后重新安排步骤。
由 admin 提交 · 收录于 5天前
⚡ System1 在这里负责什么
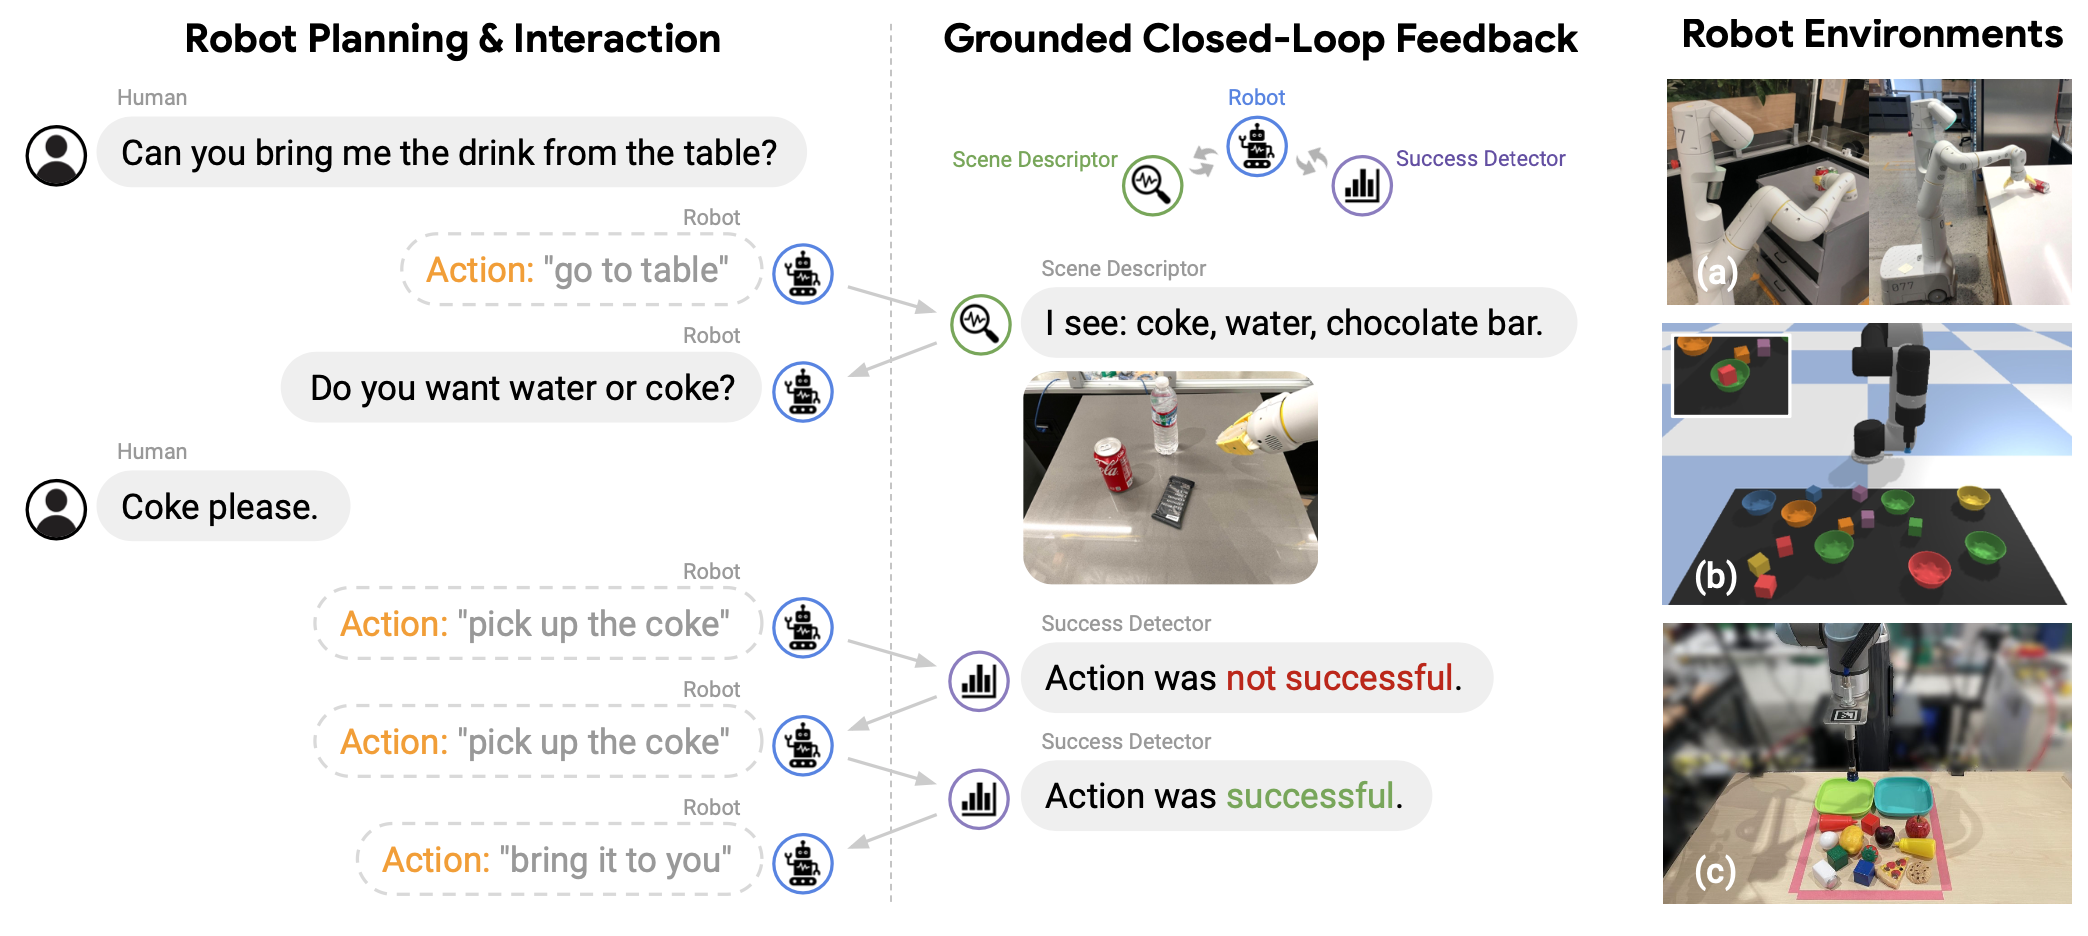
语言模型读取物体识别、场景描述、动作成功与否及人的补充说明,更新高层计划;已有低层技能负责实际运动。论文研究不额外训练该规划模型的用法,未发现 Jev 参与证据。
介绍
让机器人边做边接收反馈:例如把饮料放进抽屉时,发现前一步失败,就根据最新结果重新安排步骤。论文在模拟桌面、真实桌面和厨房移动操作中研究这一方法。 证据与边界:反馈质量和已有技能会影响结果;部分失败恢复演示人为干预机器人以制造失败。研究结果不能直接外推为任意家务、硬件或生产环境的可靠性。本次未运行项目。 原作者图片与演示(保留来源):
资料来源: https://innermonologue.github.io/ https://arxiv.org/abs/2207.05608 https://youtu.be/0sJjdxn5kcI
🧪 社区实测报告
0 份报告 · 0 份真实模型通过还没有人测试过,来做第一个吧。
💬 相关讨论
发帖 →还没有讨论。