RetiJev:眼科候选决策与指南分级
需自行部署终端从文本病例中选择检查、转诊和分级选项;公开代码与权重的眼科决策研究。
由 admin 提交 · 收录于 3小时前
⚡ System1 在这里负责什么
介绍
RetiJev 是由新加坡国立大学等机构研究者提出的眼科决策模型。它把患者文本记录与明确的问题、候选答案组合起来,判断下一步检查、转诊方向、紧急程度、方案安全性或指南分级。输入是文本化病例,不是直接读取眼底照片。
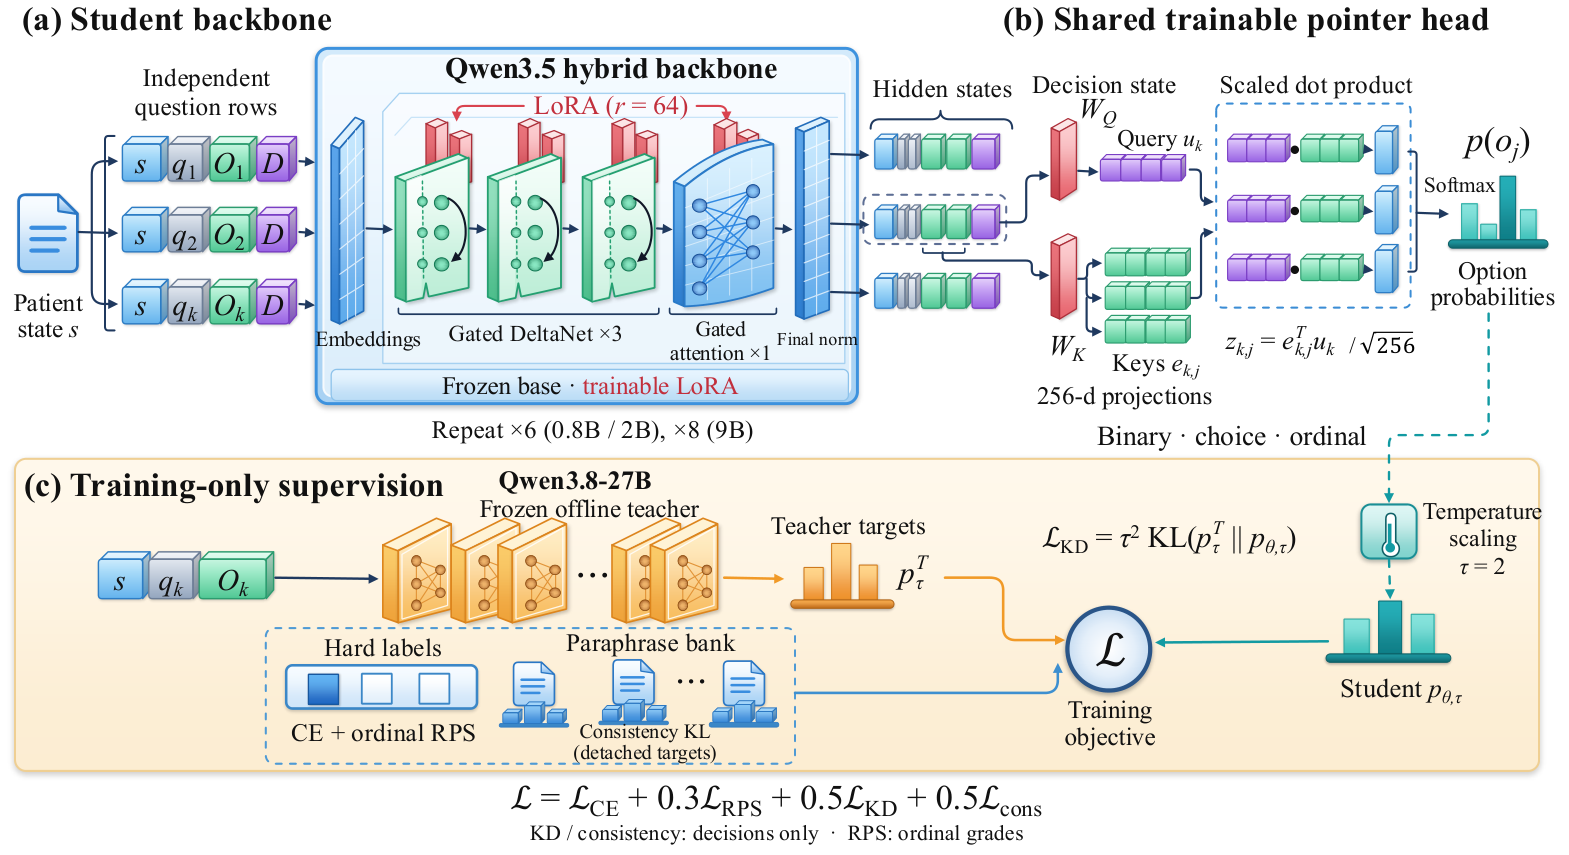
模型怎样工作 项目提供 0.8B、2B 和 9B 三种规模,在 Qwen3.5 骨干上训练 LoRA 适配器和共享的候选打分头。输入一次患者状态后,各个问题复用上下文并独立打分,不需要逐字生成回答。它属于独立开源研究项目,并非 TypeSafe 官方 Jev 产品。 一个研究工作流是:整理去标识化的病例文本 → 提供问题和允许的选项 → 获取每个选项的概率 → 应用将候选结果与另行关联的参考资料一起展示,供研究人员或医生复核。模型本身不检索或生成引文。信息不足时,应用可保留“交由临床医生判断”等候选;实际转交阈值仍需目标场景验证。
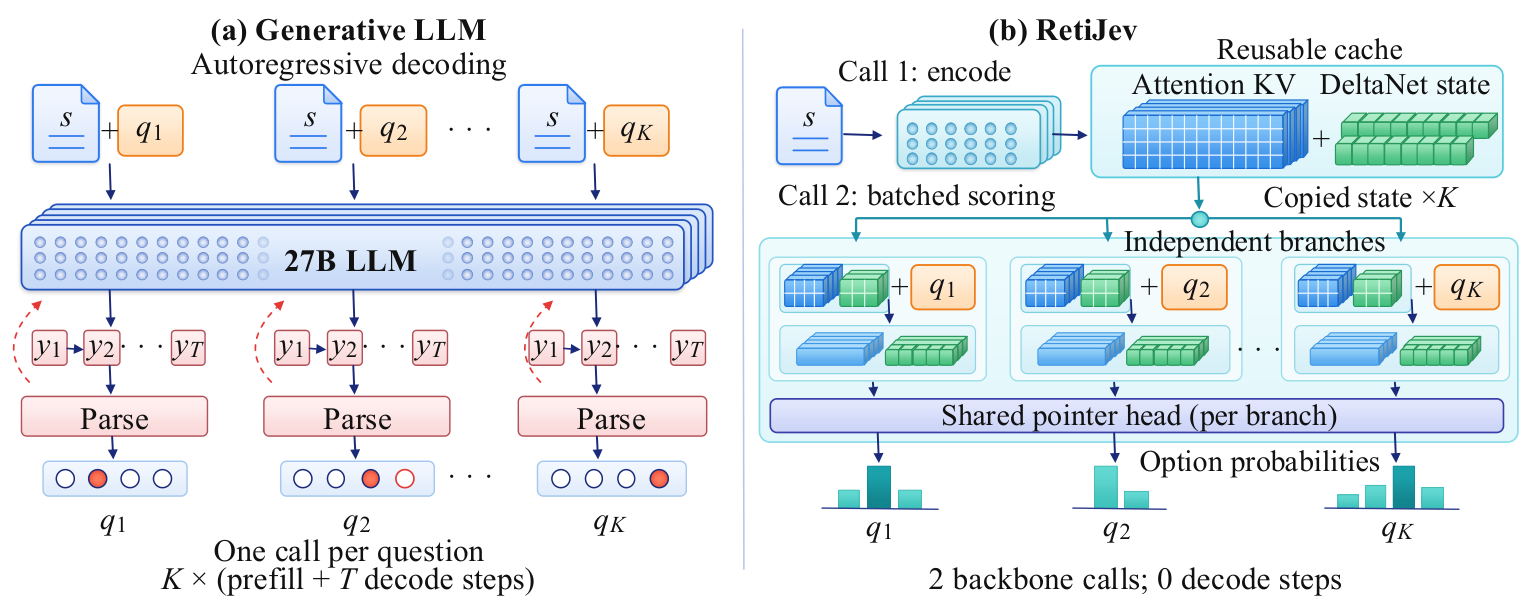
论文报告了什么 作者在合成病例基准上报告:RetiJev-9B 的 Decision-Unseen 准确率为 84.9%,两个对照均为 79.5%。在单张 NVIDIA H200、batch size 为 1、平均每例 2.65 个问题的设置下,9B 的病例级中位延迟为 158 毫秒。该数字不是所有硬件上的保证,也不是临床效果指标。 本地研究与复现 仓库提供安装说明、命令行推理示例、训练脚本和小规模示例数据;模型权重发布在 Hugging Face。使用时需要相应的 Qwen3.5 基础权重及本地推理环境。本次收录核查了论文和公开资源,未运行模型或复现基准成绩。 证据边界 这些病例由程序和模型合成。临床决策与诊断标签经过模型交叉核验,但没有由眼科医生逐例裁定,也没有前瞻性临床评估。项目仅供研究,不是经过临床验证的医疗器械;模型概率不能直接视为某位患者的诊断正确率。 媒体说明 保留了作者论文中的两张原始技术图。已检查代码仓库、Releases、作者模型页面及论文,未找到公开演示视频;命令行 demo 不等于演示录像。 来源 论文:Bo Liu、Lianyu Wang、Meng Wang、Ching-Yu Cheng、Huazhu Fu,RetiJev: Fast and Source-Grounded Ophthalmic Decision Models,2026。 https://arxiv.org/abs/2610.30947 代码:https://github.com/Awenbocc/RetiJev 模型:https://huggingface.co/BoKelvin/RetiJev 收录线索:https://mp.weixin.qq.com/s/P8QM7QpQT_qmsu9k0c0AwQ